こんにちは!とも(@tomo_ITBizBlog)です!
「インフラの経験は積んできた。次はSREに挑戦したい。でも求人を見ると、開発経験やKubernetesが並んでいて、今の自分から何年かかるのか見当がつかない」
「運用の仕事は回せるようになったけれど、このままでは『運用の人』で止まってしまう気がする」
そんなモヤモヤを抱えていませんか。
本記事はこんな悩みを解決!
- SREの求人要件と自分のスキルの差分が分からず、移行にかかる年数の見当がつかない
- インフラ経験のどこがSREで評価され、どこが足りないのかを知りたい
- 何から、どの順番で埋めていけばいいのか、移行の地図がほしい
この記事で分かること
- SREの仕事内容と、インフラエンジニアとの違い
- 移行でつまずくポイントが「型の違い」で起きる理由
- インフラ経験者向けの移行の順番(土台の棚卸し→コード→自動化→コンテナ→SREの型)
- 転職・フリーランス・副業、それぞれの形態での現実と次の一歩
先に、筆者の立場をはっきりさせておきます。
筆者には、SREという職種タイトルで働いた経験はありません。この記事は、SRE経験者の体験談ではありません。
筆者の実務は、運用監視からインフラ(構築を含む)、クラウド(AWS特化)を経てフリーランスという流れで、TerraformやCloudFormationによるIaC(インフラのコード化)や、運用の改善をしてきました。
つまり筆者も、SREに近接する領域にいる実務者の一人です。
この記事では、公開されている求人要件やSREの公開情報と、筆者自身の実務を突き合わせながら、インフラ経験者がSREへ移るための現実的な順番を整理します。
【SREとは?サービスの「信頼性」を設計するエンジニア】
SRE(Site Reliability Engineering)は、Webサービスやシステムの「信頼性」を、エンジニアリングで高める職種です。Googleが提唱した考え方として知られています。
一言でいうと、運用を「人の手で回し続ける仕事」から、「ソフトウェアで解く仕事」に変える役割です。
インフラエンジニアとの違いは、見る対象に表れます。
インフラエンジニアが「基盤を作って守る」のに対し、SREは「サービスの信頼性を指標で測り、改善し続ける」ことが仕事の中心です。
具体的には、SLO(サービスレベル目標)という形で「どこまで安定していればよいか」を数値で決め、エラーバジェット(許容できる失敗の枠)の中で、改善と新機能のバランスを取る運用をします。
需要の背景には、IT人材全体の不足があります。
経済産業省「IT人材需給に関する調査」(2019年公表)の試算では、2030年にIT人材は中位シナリオで約45万人、最も厳しい前提では最大で約79万人不足するとされています。
レバテックの調査でも、2025年12月時点のIT転職求人倍率は10.4倍と報告されています。
ただしSREについては、不足の形が少し違います。未経験の入口はほぼなく、求人はインフラや開発の経験者の横移動が中心です。当サイトのカオスマップでも、SREは第3群に位置し、不足度は「高」としています。
では、インフラ経験者からだと何年かかるのか。
結論を先に言うと、土台はすでにあります。求人要件の中心は「インフラ・運用の経験」に「開発・自動化の経験」を上乗せしたもので、不足分を埋める期間として1〜2年を目安とする声が多い領域です。もちろん、現在の到達度によって前後します。
その順番は後の章で示します。まずは、SREが日常で何をしているかから見ていきます。
25職種全体の位置づけは、エンジニア職種カオスマップの記事で整理しています
【SREの仕事内容|指標運用と自動化とインシデント対応】
SREの日常は、大きく5つの仕事で回っています。
- 指標の運用:SLOを設定し、信頼性の状態を測って、改善の優先順位を決める
- 自動化とトイル削減:繰り返しの手作業(トイル)を洗い出し、コードで潰していく
- インシデント対応:障害時の切り分けと復旧を主導し、振り返り(ポストモーテム)を文書に残す
- 可観測性の整備:メトリクス・ログ・トレースといった「状態を見る仕組み」そのものを作る
- リリースと容量の設計:デプロイの仕組み化と、需要に対するキャパシティの計画
日常的に触る技術は、クラウド(AWSなど)、Kubernetes、TerraformなどのIaC、CI/CDの仕組み、監視基盤(PrometheusやGrafanaなど)、そしてGoやPythonといったプログラミング言語です。
成果物は、画面やシステムそのものだけではありません。
ダッシュボードやアラートの設計、自動化の仕組み、ポストモーテムの文書、SLOのレポートといった「測って、改善するための道具と記録」が成果物になります。
現場の形態にも特徴があります。
SREは自社サービスを持つ企業に多い職種です。受託や常駐の現場にもSREの名の求人はありますが、実態は運用保守に近いものも混ざっています。この「看板と実態の距離」は、後の章で改めて触れます。
筆者も運用とインフラの現場にいた立場から見ると、障害対応や監視といった土台は、運用監視・インフラの仕事と地続きです。
違いは、その上に「コードで直す」「指標で判断する」という2つの型が乗ることです。ここが、移行の順番を決めるポイントになります。
【SREのメリット・デメリット】
良い面と厳しい面を、対にして整理します。
メリットは次のとおりです。
- インフラと開発の両方にまたがるため、スキルが複合で積み上がり、市場価値が一方向に偏らない
- 手作業を減らす側の仕事なので、運用の「回し続ける消耗」から抜け出しやすい
- サービスの信頼性という、事業に直結する指標を扱うため、仕事の評価軸が明確になる
- 経験者中心の市場で不足度が高く、土台のある人には追い風になっている
デメリットは次のとおりです。
- 参入の前提が高い。インフラと開発、両方の素養を求められる
- 障害のときは最前線に立つ。オンコール(待機対応)の有無や頻度は、会社によって差が大きい
- 「SRE」の名でも実態は運用保守という求人が混ざっており、見極めを誤ると移行にならない
- SLOのような指標運用は、会社に文化がないと形だけになり、評価されにくい現場もある
ポイントは、デメリットが「入るまでのハードル」と「入った先の見極め」に集中していることです。
逆に言えば、土台と見極めさえ押さえれば、インフラ経験がそのまま資産になる職種だと言えます。
【移行で詰まるポイントと沼|壁はスキルの量ではなく型の違い】
SREへの移行でつまずくポイントは、だいたい決まっています。しかも、その多くはスキルの総量ではなく、「求められる型の違い」の問題だと言われています。
1つ目は、「運用ができる」と「SREができる」の型の違いです。
手順書に沿って正確に回す運用と、問題そのものをコードで潰す運用は、別の型です。監視や障害対応の経験は土台になりますが、それだけでは求人要件に届かない、というのが公開されている求人の並びから見える実態です。
2つ目は、プログラミングの壁です。
自動化のスクリプトを書くところまでは来ていても、開発チームと対等にコードを読んだり、レビューを受けたりする場面で止まる人は多いと言われます。
テストの考え方や、コードを「作品」として管理する作法は、インフラ畑だけでは触れる機会が少ない部分です。
3つ目は、コンテナとKubernetesの前提です。
SRE求人の多くが前提にしていますが、オンプレミスや仮想マシン中心のインフラ経験では、触れていない人も少なくありません。業務で機会がない分、学習環境を自分で用意する必要が出てきます。
4つ目は、指標の考え方に触れたことがない問題です。
SLOやエラーバジェットは、従来の運用現場では扱わないことがほとんどです。「信頼性を感覚ではなく数字で語る」型は、現場で自然には身につかず、独学でも後回しにされやすい部分です。
5つ目は、求人の「SRE」看板問題です。
移行先に選んだ求人が、実態は夜間対応中心の運用保守だった、というミスマッチが起きやすい職種です。入りやすい求人ほど、看板と実態の距離を確認する必要があります。
6つ目は、経験の言語化です。
インフラ経験者は「止めなかった」「復旧させた」という実績を持っています。ただ、それを「信頼性をどう改善したか」という形で語る型を持っていないと、選考の場で評価に届きにくい、という構造があります。
まとめると、壁の正体は「コードで解く型」と「指標で語る型」への転換、そして看板の見極めです。
だから対策は、スキルの総量を増やすことではなく、転換の順番を先に固定することです。次の章の後に、その順番を示します。
【SREに向いている人・いない人】
向いている人は、次のようなタイプです。
- 手作業を見ると「これ、自動化できないか」と先に考える
- 障害対応の切り分けが好きで、原因を仕組みで潰すことにやりがいを感じる
- 状態を数字で測り、改善の効果を確かめるのが苦にならない
- インフラと開発の両方に、興味が広がっている
向いていない人は、次のようなタイプです。
- コードを書く仕事そのものに抵抗が強く、運用の安定志向が強い
- 決まった手順を正確に回す仕事のほうが、性に合っている
- 障害のときに最前線に立つプレッシャーは、できるだけ避けたい
向いていない側に当てはまったら、無理にSREに寄せる必要はありません。
クラウド側で設計・構築を深める道もあれば、インフラの上位として設計側へ進む道もあります。大事なのは、職種の人気ではなく、自分が続けられる形で選ぶことです。
【SREになるための手順|インフラ経験者の移行マップ】
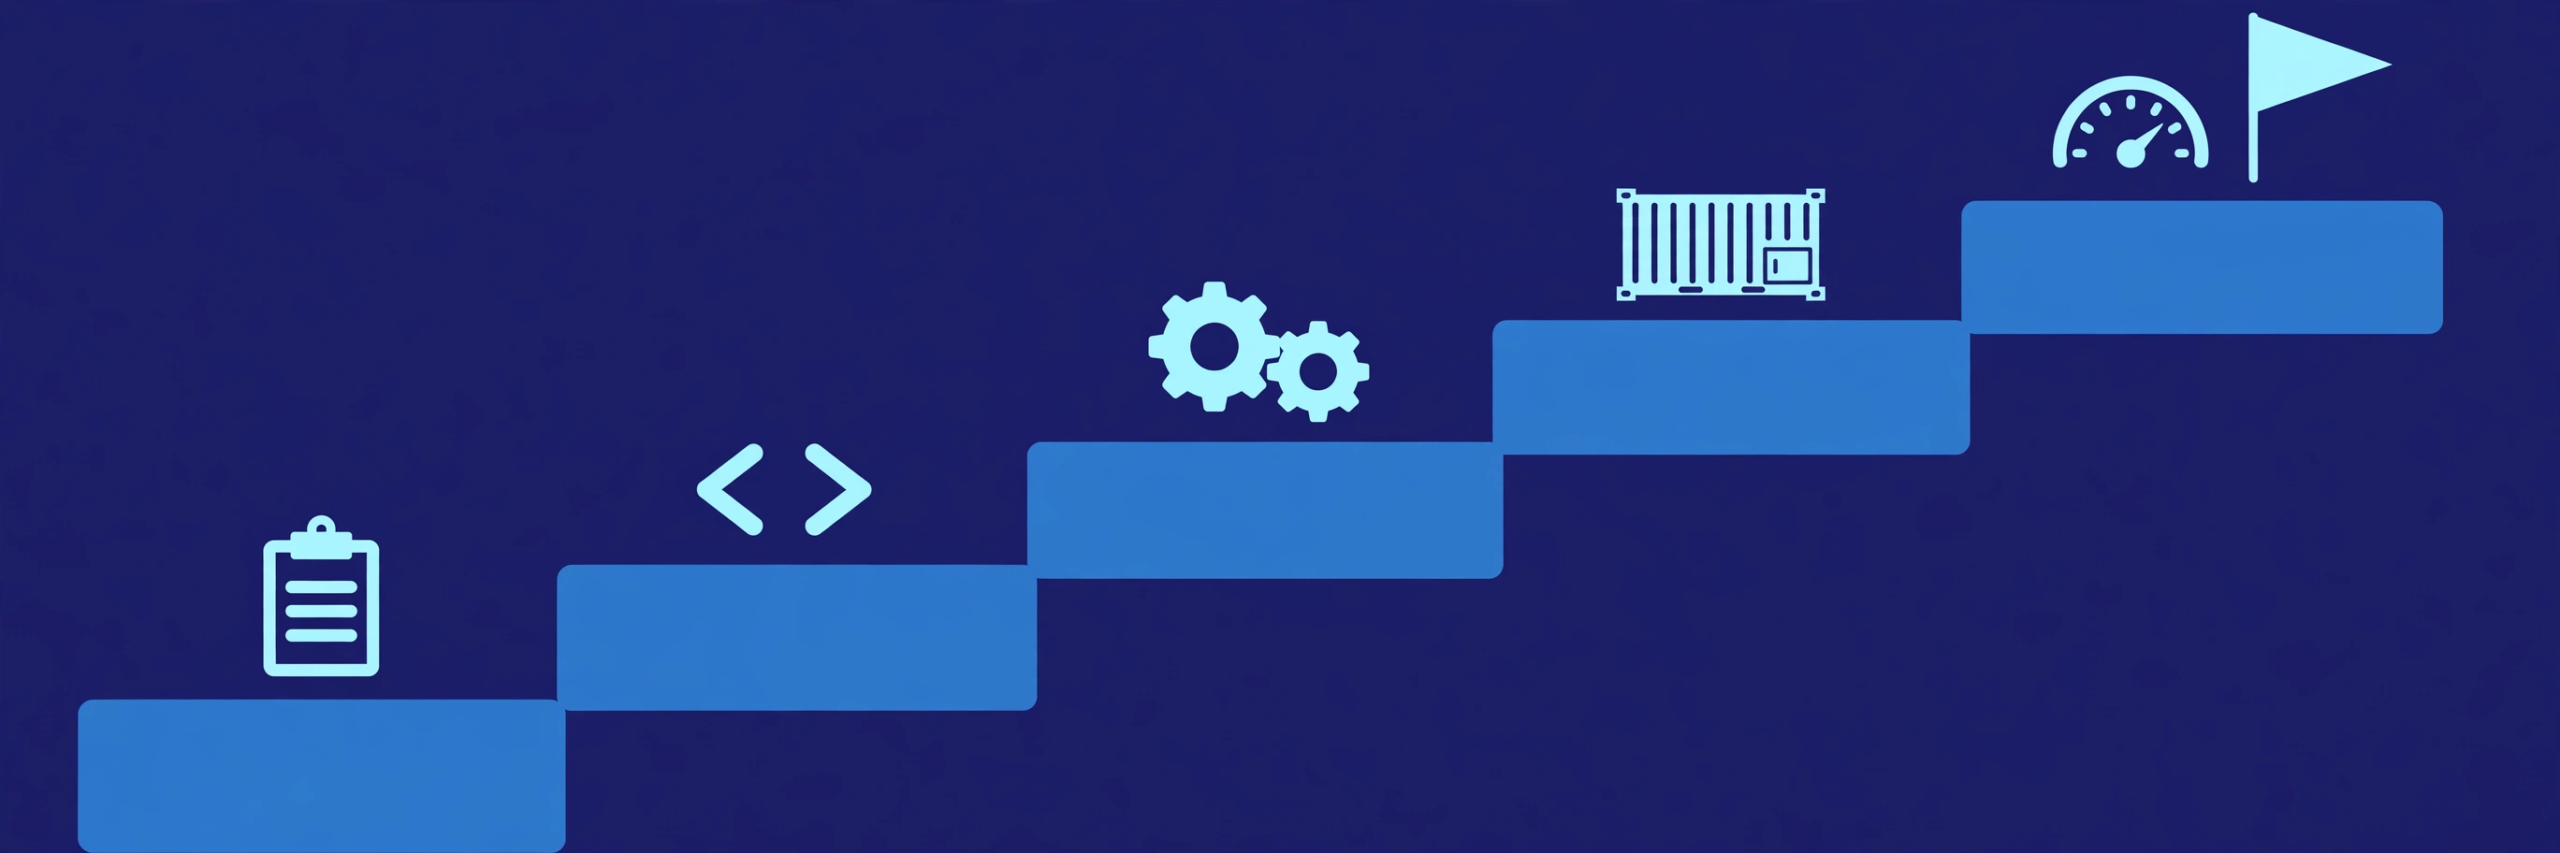
順番の結論を先に言います。土台の棚卸し→プログラミング→IaCと自動化→コンテナとKubernetes→SREの型、の順です。
これは未経験者向けの基礎学習ではなく、インフラ経験者が「差分だけ」を埋めるための順番です。
Lv1:土台を棚卸しして、差分リストを作る
- 学ぶこと:自分の経験が「監視・運用/構築/クラウド」のどこまで届いているかの棚卸し
- 作るもの:SRE求人の要件と突き合わせた、差分リスト(メモでよい)
土台の全体像の確認には、インフラエンジニアのロードマップが使えます。現在地が曖昧なまま進むと、後の学習が空回りします。
Lv2:プログラミングを「読める・書ける」に引き上げる
- 学ぶこと:PythonかGoで、業務の自動化を題材にコードを書く。あわせてGitの作法と、テストの考え方
- 作るもの:今の運用作業を置き換えるツール1本
言語は1つに絞ってください。目的は「開発者になること」ではなく、「コードで解く型」を手に入れることです。
Lv3:IaCとCI/CDで、変更をコードで管理する型を作る
- 学ぶこと:Terraformなどで既存の構成をコード化し、変更をパイプラインで流す流れ
- 作るもの:検証環境一式のコード化と、その変更履歴
筆者自身の実務でも、TerraformとCloudFormationの両方を扱ってきましたが、この「変更をコードで残す」型が、SREの求人要件と最も重なる部分だと感じています。
Lv4:コンテナとKubernetesに触れる
- 学ぶこと:コンテナの基礎と、Kubernetesの概念・運用の入口
- 作るもの:検証環境にアプリを載せ、監視まで付けた一式
業務で触れる機会がない領域なので、自分で環境を用意して手を動かすことが前提になります。資格では、Kubernetesの認定(CKAなど)が学習の目安として挙がることが多い領域です。
Lv5:SREの型(SLO・ポストモーテム)を学ぶ
- 学ぶこと:SLOとエラーバジェットの考え方、ポストモーテムの書き方といった、SREの公開されている型
- 作るもの:想定したサービスでのSLO設計と、ダッシュボード・アラートの一式
資格では、AWS認定DevOps Engineer - Professionalのように、自動化と運用の複合を証明するものが近い位置にあります。資格全体の順番は、資格まとめで確認しながら決めるのがおすすめです。
参入口の現実も書いておきます。
SRE求人は経験者向けが中心で、選考では「自動化した実績」と「コードで残した成果物」が効きます。
また、転職だけが入口ではありません。現職で運用改善を任せてもらう、といった役割の拡張が、最初の実績づくりになるケースも多い職種です。
年数の目安に戻ると、この順番を現職と並行して進める場合、差分の大きさによって1〜2年が現実的な目安と言われることが多いです。
クラウド構築まで届いている人は短く、仮想マシンの運用中心だった人は長くなる。その差を決めるのは、Lv1で作った差分リストの厚みです。
【転職・フリーランス・副業で変わるSREの現実】
働き方の3形態で、この職種の現実を見ます。
まず転職(正社員)です。
SRE求人は自社サービスを持つ企業が中心で、求められるのはインフラ経験に、自動化や開発の実績を重ねた人です。「インフラ・運用の経験が3年前後から」という書き出しの求人は珍しくありません。
未経験の枠はほぼない前提で動くのが現実的で、その分、土台のある人には不足度の高さが追い風になります。
次にフリーランスです。
SREやDevOpsのフリーランス案件は存在しますが、即戦力が前提で、クラウドとKubernetes、自動化の複合が求められます。具体的な単価は案件と経験で大きく変わるため、本記事では断定しません。
筆者自身もAWS特化のフリーランスとして活動していますが、インフラ側の実績に自動化と信頼性の領域を広げていく形は、複合の作り方の一つです。
最後に副業です。
SREの副業案件は薄いのが実態です。サービスの信頼性への責任は継続的に発生するため、本業の合間に担う形は成立しにくく、副業は「移行して、実績ができてから検討する」順番が現実的です。
3形態に共通するのは、「信頼性を改善した実績」がそのまま評価の通貨になることです。
そして、どの形態でも土台になるのはクラウドの実務です。SREへの移行を考えるなら、まずクラウド側の到達度を固めることが、遠回りに見えて一番の近道になります。
\ SREの土台はクラウド実務。移行の第一歩を固めたい方へ /
【SREの次のステップ|プラットフォームと信頼性の専門深化】
SREを到達点として、次に進む方向は主に3つです。
1つ目は、プラットフォームエンジニアです。
社内の開発基盤そのものを作り、他の開発チームに提供する職種で、SREの先にある専門職として近年増えています。当サイトのカオスマップでも、独立した職種として扱っています。
2つ目は、信頼性の専門を深める方向です。
複数のサービスを横断して信頼性の設計を担い、指標運用やインシデント対応の型を組織に広げる側へ進む道です。
3つ目は、クラウド側との往復と複合です。
クラウドの設計・構築と信頼性の両方を持てると、任せられる範囲が一段広がります。SREからクラウド側へ戻る動きも、複合を作るうえでは有効です。
クラウド側への進み方は、クラウドエンジニアの記事で整理しています
どの方向でも条件になりやすいのは、「複数のサービスの信頼性を見た経験」と「基盤や仕組みを、他チームに提供した実績」です。
入口で身につけた「測って、直して、残す」型は、そのまま次の職種でも通貨になります。
【まとめ|SREへの移行は、年数ではなく差分で測る】
要点を3つにまとめます。
- SREは、サービスの信頼性をエンジニアリングで守る職種。入口は未経験ではなく、インフラ経験者の横移動が中心
- 移行の壁はスキルの量ではなく、「コードで解く型」と「指標で語る型」への転換にある
- かかる年数は土台の到達度で変わる。棚卸し→コード→自動化→コンテナ→SREの型、の順で差分を埋めるのが移行の地図
今、運用やインフラの現場にいる方は、まずLv1の棚卸しから始めてください。差分が見えれば、年数の見当も自然とつきます。
職種全体の地図の中で現在地を確認したい方は、カオスマップの記事に戻ってみてください。
\ SREの土台はクラウド実務。移行の第一歩を固めたい方へ /